- Publicado em
- · 10 de julho de 2026
Distância Euclidiana: O Que É, Fórmula e Usos em Python
- Blog

- Henrico Piubello
- Henrico Piubello
- Especialista de TI - Grupo Voitto
Especialista de TI - Grupo Voitto
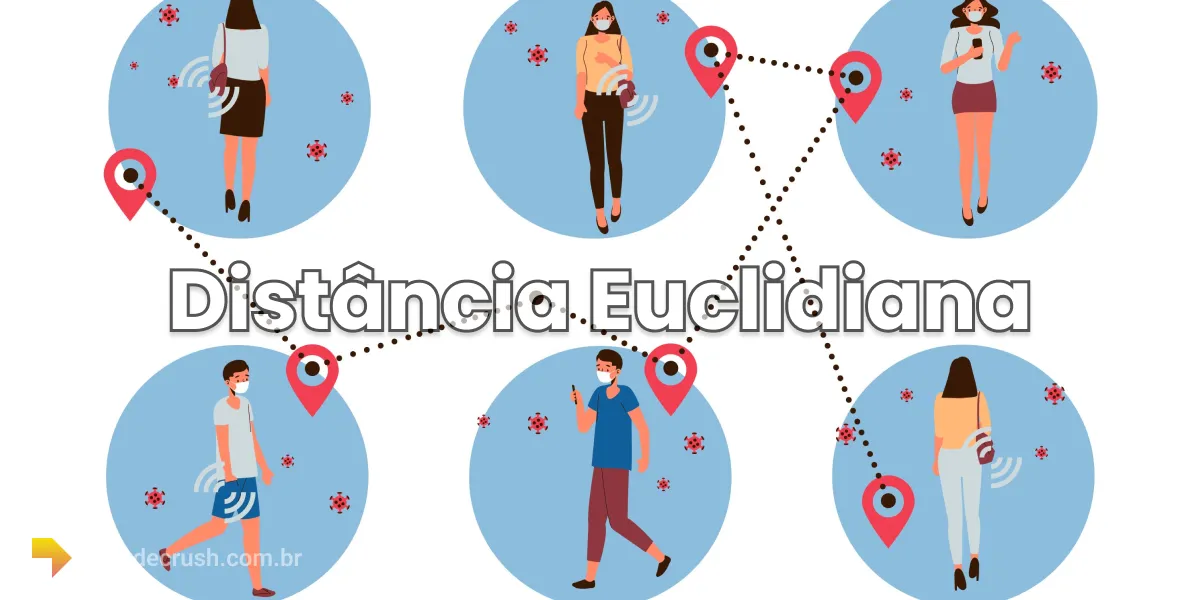
A distância euclidiana é a medida do segmento de reta mais curto entre dois pontos, calculada pela raiz quadrada da soma dos quadrados das diferenças entre as coordenadas. Em programação e ciência de dados, ela quantifica a similaridade entre registros e sustenta algoritmos como KNN e K-Means.
- O que é distância euclidiana?
- Qual a diferença entre distância euclidiana e outras métricas?
- Como calcular a distância euclidiana em Python?
- Onde a distância euclidiana é usada em machine learning?
- Quando usar a distância euclidiana na ciência de dados?
O que é distância euclidiana?
A distância euclidiana é uma métrica que mede o comprimento do segmento de reta entre dois pontos em um espaço euclidiano — o menor caminho possível entre eles. Derivada do teorema de Pitágoras, ela vale tanto para o plano bidimensional quanto para espaços com qualquer número de dimensões, o que a torna a medida direta mais usada em geometria e em análise de dados.
A fórmula geral para dois pontos p e q com n dimensões é:
d(p, q) = √((q₁ - p₁)² + (q₂ - p₂)² + ... + (qₙ - pₙ)²)
Para dois pontos em um plano, (x₁, y₁) e (x₂, y₂), a expressão se reduz a √((x₂ - x₁)² + (y₂ - y₁)²). Na prática da programação, cada ponto costuma representar um registro de dados — as preferências de um usuário, os atributos de um produto — e vale a regra central desta métrica: quanto menor a distância euclidiana entre dois conjuntos de dados, maior a similaridade entre eles.
Qual a diferença entre distância euclidiana e outras métricas?
A distância euclidiana mede o caminho em linha reta entre dois pontos, enquanto métricas como Manhattan, cosseno e Hamming medem diferenças por eixo, ângulo entre vetores ou posições divergentes. A escolha depende do tipo de dado e do que o modelo de machine learning precisa capturar.
| Métrica | Como mede | Uso típico |
|---|---|---|
| Euclidiana | Linha reta entre dois pontos | KNN, K-Means, dados contínuos |
| Manhattan | Soma das diferenças absolutas | Alta dimensionalidade, outliers |
| Cosseno | Ângulo entre vetores | Textos e sistemas de recomendação |
| Minkowski | Generaliza Euclidiana e Manhattan | Ajuste fino via parâmetro p |
| Hamming | Posições diferentes entre símbolos | Dados categóricos e binários |
Um cuidado importante: a distância euclidiana é sensível à escala das variáveis. Se uma coluna varia de 0 a 1 e outra de 0 a 10.000, a segunda domina o cálculo. Por isso, normalizar ou padronizar os dados antes de medir distâncias é etapa obrigatória em qualquer pipeline sério de análise.
Como calcular a distância euclidiana em Python?
Em Python, a distância euclidiana se calcula com a função math.dist da biblioteca padrão — disponível desde o Python 3.8, segundo a documentação oficial — ou com numpy.linalg.norm para vetores de qualquer dimensão. Para começar do zero, o roteiro é simples:
- Importe o módulo
math(ou o NumPy, para vetores multidimensionais). - Defina os dois pontos como tuplas ou arrays de coordenadas.
- Calcule a raiz quadrada da soma dos quadrados das diferenças entre as coordenadas.
import math

def distancia_euclidiana(ponto1, ponto2):
    x1, y1 = ponto1
    x2, y2 = ponto2
    return math.sqrt((x2 - x1)**2 + (y2 - y1)**2)

distancia_euclidiana((1, 2), (4, 6))  # 5.0
math.dist((1, 2), (4, 6))  # equivalente na stdlib (Python 3.8+), 5.0
Para dados multidimensionais, a função numpy.linalg.norm resolve em uma linha e de forma vetorizada:
import numpy as np

a = np.array([1, 2])
b = np.array([4, 6])
np.linalg.norm(a - b)  # 5.0
Se você está começando na linguagem, vale revisar o guia de Python para iniciantes e o artigo sobre a biblioteca NumPy para dominar arrays antes de trabalhar com métricas de distância.
Onde a distância euclidiana é usada em machine learning?
A distância euclidiana é o critério de similaridade padrão de algoritmos clássicos de classificação e agrupamento: o KNN (K-Nearest Neighbors) classifica um novo ponto olhando os vizinhos mais próximos, e o K-Means agrupa observações minimizando distâncias aos centroides. Na documentação oficial do scikit-learn, o KNeighborsClassifier usa por padrão a métrica de Minkowski com p=2 — exatamente a distância euclidiana.
Esse alcance é amplificado pelo tamanho do ecossistema. Segundo a Stack Overflow Developer Survey 2025, o Python é usado por 57,9% dos desenvolvedores, um salto de 7 pontos percentuais em um ano puxado por IA (Inteligência Artificial) e ciência de dados. E a Python Developers Survey 2024, conduzida pela PSF (Python Software Foundation) com a JetBrains junto a mais de 30.000 respondentes, mostra que 51% dos desenvolvedores Python trabalham com exploração e processamento de dados — o terreno natural das métricas de distância.
Um exemplo concreto: em um sistema de recomendação, cada usuário vira um vetor de preferências. Ao calcular a distância euclidiana entre o vetor de um usuário e o dos demais, o sistema encontra perfis semelhantes e recomenda itens que esses perfis já aprovaram. Para entender o contexto maior desses algoritmos, veja os fundamentos do machine learning explicados passo a passo.
Quando usar a distância euclidiana na ciência de dados?
Use a distância euclidiana quando as variáveis forem contínuas, estiverem na mesma escala (ou normalizadas) e o número de dimensões for baixo ou moderado. Nessas condições, ela é a métrica mais intuitiva e barata de calcular para análise de clusters, detecção de anomalias e busca por similaridade.
Na análise de agrupamentos, calcular a distância euclidiana entre pontos de um conjunto multidimensional ajuda a identificar padrões e reunir dados semelhantes. Imagine a análise de clientes de um e-commerce: a métrica agrupa consumidores com comportamentos de compra parecidos, gerando insights para estratégias de marketing personalizadas. Em aplicações geoespaciais, como um programa que estima a rota mais curta entre dois pontos de um mapa com coordenadas de GPS (Sistema de Posicionamento Global), a distância euclidiana fornece a linha de base da distância direta antes de considerar ruas e obstáculos.
O limite aparece em espaços com centenas ou milhares de dimensões: as distâncias entre todos os pontos tendem a se igualar (maldição da dimensionalidade) e a métrica perde poder discriminativo. Nesses cenários, reduza dimensões antes ou troque por Manhattan ou similaridade de cosseno, como resume a tabela comparativa acima.
Conclusão
A distância euclidiana é daqueles fundamentos que valem mais do que aparentam: uma fórmula de uma linha, herdada de Pitágoras, sustenta KNN, K-Means, recomendação e análise de clusters. O conselho prático do CodeCrush é direto — antes de adotar métricas exóticas, normalize seus dados, comece pela euclidiana e só troque de métrica quando os resultados do modelo mostrarem que ela não basta. Dominar essa base torna qualquer estudo posterior de algoritmos de similaridade muito mais rápido.
Recomendações para este tema
Selecionados pela redação — só o que usaríamos.
Eficax Shop Informática e Games
Kit Gamer Periféricos Teclado Uma Mão
Eficax Shop Informática e Games
Kit Mobilador Completo de Headset Hub 3.0 Mouse Gamer Led Pad Speed Suporte de Celular
Bookcenter RJ
Kit Upgrade INTEL I5 4570 + Placa Intel H81 + Memória 8 GB+ Cooler
## faq
Perguntas frequentes
Para que serve a distância euclidiana em machine learning?
A distância euclidiana mede a similaridade entre registros: quanto menor a distância, mais parecidos os dados. O KNN a usa para classificar novos pontos pelos vizinhos mais próximos, o K-Means a utiliza para agrupar observações em clusters, e sistemas de recomendação a aplicam para comparar perfis de usuários e sugerir itens.
Como calcular a distância euclidiana em Python?
Use math.dist(p, q) da biblioteca padrão, disponível desde o Python 3.8, ou numpy.linalg.norm(a - b) para vetores de qualquer dimensão. As duas funções retornam a raiz quadrada da soma dos quadrados das diferenças entre coordenadas; a versão com NumPy é vetorizada e mais rápida para grandes volumes de dados.
Distância euclidiana ou Manhattan: qual escolher?
A euclidiana mede o caminho em linha reta e é o padrão quando as variáveis são contínuas e estão na mesma escala. A Manhattan soma as diferenças absolutas por eixo e costuma ser mais robusta a outliers e a dados de alta dimensionalidade. Teste as duas métricas e compare o desempenho do modelo.
Quando a distância euclidiana não é uma boa escolha?
Evite a distância euclidiana quando as variáveis estão em escalas muito diferentes sem normalização, quando há muitas dimensões (a chamada maldição da dimensionalidade) ou quando a direção importa mais que a magnitude, como em vetores de texto. Nesses casos, similaridade de cosseno ou distância de Manhattan funcionam melhor.
Temas deste artigo
## continue lendo
Artigos relacionados
Continue navegando
Artigo anterior
AWS, Azure ou GCP: qual serviço de nuvem escolher?
AWS lidera a nuvem com 28% do mercado, à frente de Azure (21%) e GCP (14%). Compare tipos de serviço, pontos fortes e quando usar cada provedor.
Leia maisPróximo artigo
Estruturas de Dados: Arrays, Pilhas, Filas, Árvores e Hash
Estruturas de dados organizam informações na memória: arrays e listas guardam coleções, pilhas e filas controlam a ordem e tabelas hash aceleram buscas.
Leia maisSobre o autor