- Publicado em
Jev, da TypeSafe: o modelo que devolve decisão, não texto
- Blog

- Henrico Piubello
- Henrico Piubello
- Especialista de TI - Grupo Voitto
Especialista de TI - Grupo Voitto
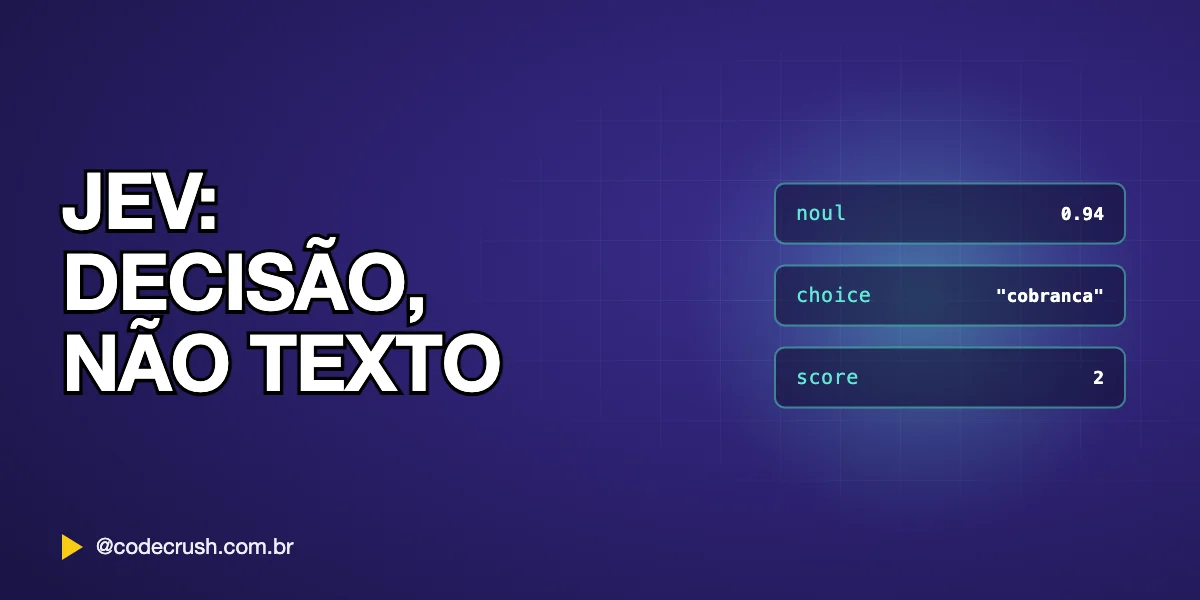
Quase toda a conversa sobre IA nos últimos anos girou em torno de modelos que escrevem. Mas se você abrir o código de um produto que usa IA hoje, vai encontrar um punhado de chamadas que não têm nada a ver com escrever: este chamado é urgente?, em qual fila isso entra?, de 0 a 5, quão irritado está este cliente?. São decisões. E, para tomá-las, o software pede um texto a um modelo de chat, reza para vir em JSON e converte de volta.
No dia 15 de setembro de 2026, a TypeSafe AI lançou o Jev com uma tese direta: esse caminho é um desvio caro. O Jev não conversa. Ele devolve a decisão.
O que é um "System One model"?
A TypeSafe batizou a categoria de System One, numa referência ao pensamento rápido e automático de Kahneman, em oposição ao raciocínio lento e deliberado. A definição da empresa é "uma nova classe de modelos de fronteira construídos para tomar decisões rápidas e estruturadas que o software consegue usar diretamente".
Na prática, a diferença é esta:
- Um LLM recebe texto e gera tokens em sequência, um dependendo do anterior. Se você quer uma resposta estruturada, precisa restringir a decodificação e depois fazer o parse.
- O Jev recebe um estado não estruturado e devolve, numa única consulta paralela, um valor já tipado. Nas palavras da documentação, ele "abre mão da geração de string".
Não é um LLM com um validador na saída. É um modelo treinado para outra coisa, com um método próprio que a empresa chama de RLCD (Reinforcement Learning for Calibrated Decisions), em contraste com o RLHF e o RLVR que treinam os modelos de chat.
Como o Jev funciona na prática?
A API expõe três primitivas de decisão. É pouco de propósito:
| Primitiva | O que devolve | Exemplo de uso |
|---|---|---|
noul | Booleano como probabilidade | "Este cliente está pedindo reembolso?" |
choice | Uma opção de uma lista fechada | Rotear para cobranca, tecnico ou conta |
score | Nota numa escala definida | Nível de frustração de 0 a 2 |
A chamada é um POST /v1/systemone (o modelo padrão é jev-latest), e você envia um state: os dados que a decisão precisa enxergar. O estado aceita strings, objetos JSON e arrays de texto.
A resposta traz três coisas, e a terceira é a que muda o desenho do sistema:
- O valor tipado, no formato que você declarou.
- A probabilidade que o modelo atribui.
- Um score de confiança, para o seu código decidir se age sozinho ou escala para um humano.
O padrão que a documentação sugere é montar o estado uma vez e disparar várias perguntas independentes ao mesmo tempo — pediu reembolso?, é cobrança duplicada?, está dentro da política? — e então combinar as respostas tipadas com lógica determinística no seu código. A decisão final não fica no modelo. Fica no if.
Os números são reais?
Aqui vale separar o que é medição, o que é anúncio e o que é ressalva da própria empresa.
O que a TypeSafe anuncia:
- Latência de ponta a ponta de 70 ms a 500 ms, contra 3 a 329 segundos dos modelos de fronteira que ela usou como comparação.
- US$ 0,042 por milhão de tokens de entrada, com saída gratuita — "barato demais para medir".
- 40x a 200x mais rápido para consultas de decisão estruturada, com a mesma qualidade de inteligência.
A ressalva que a própria empresa faz: a comparação mais chamativa — 193,6x mais rápido e 444,6x mais barato — vem de avaliações de fluxo de trabalho, e o texto admite que esses valores "estão na ponta alta dos ganhos do mundo real". Quem reproduzir isso num caso comum deve esperar menos.
Os comparativos foram feitos contra GPT-5.6 Terra, GPT-6 Astra e Fable 5.1. A demonstração pública mais citada é o Jev jogando Doom: o modelo recebe o estado do jogo e devolve decisões tipadas rápido o bastante para o jogo seguir.
Onde a promessa de "não alucina" termina
Esta é a parte que merece atenção de quem vai colocar isso em produção.
A TypeSafe afirma que o Jev "não consegue alucinar", porque ele só escolhe entre as respostas permitidas. Isso é verdade — e é uma verdade menor do que parece à primeira leitura.
O que a garantia cobre: conformidade de tipo. O modelo nunca devolve uma categoria que não existe, nunca quebra o schema, nunca inventa um campo. Erro de parse deixa de ser uma classe de bug.
O que a garantia não cobre: estar certo. Se as opções são cobranca, tecnico e conta, e a resposta correta era cobranca, o modelo pode devolver tecnico com toda a tipagem em ordem. É uma resposta perfeitamente válida e perfeitamente errada.
A própria documentação é honesta quanto a isso, e vale citar: "Our number is not empirical. Schema matching is guaranteed, thus we can confidently add 0%". Ou seja, o 0% de alucinação não saiu de uma medição — saiu da definição.
É exatamente por isso que o score de confiança importa mais do que o número de marketing. A pergunta certa para o seu sistema não é "ele alucina?", e sim "a partir de qual confiança eu deixo isso passar sem revisão?".
Isso não é só o JSON mode de sempre?
É a primeira pergunta de qualquer dev que já usou saída estruturada, e ela é justa.
Na garantia de formato, os dois chegam no mesmo lugar: decodificação restrita num LLM também impede resposta fora do schema. Se o seu problema era só parse quebrado, você já tinha solução.
A diferença que a TypeSafe defende está em outro eixo — e é uma diferença de arquitetura, não de validação. Como o Jev responde em paralelo, numa passada só, em vez de gerar tokens em sequência, ele muda a conta de latência e de custo. Você não paga pela máquina de escrever texto que não vai usar. Somando isso à probabilidade calibrada, que um LLM em JSON mode não entrega de forma confiável, o argumento fecha melhor no custo por decisão do que na correção do formato.
Vale dizer que a cobertura independente do lançamento, até aqui, repetiu os números da empresa sem verificação de terceiros. Ainda não há benchmark externo.
Quando faz sentido olhar para o Jev
Faz sentido avaliar se você tem um volume alto de chamadas do tipo classificar, rotear, pontuar, filtrar — especialmente as que hoje rodam num modelo de chat pedindo JSON, e nas quais latência ou custo já incomodam. Moderação de conteúdo, triagem de tíquete, roteamento de atendimento e enriquecimento de dados são os casos naturais, e a lógica se encaixa bem em automações com IA e no laço de decisão de agentes de IA.
Não faz sentido se o que você precisa é texto. O Jev não escreve código, não redige e-mail, não resume documento. Ele não é substituto de ChatGPT ou Claude — é uma peça diferente, que convive com eles no mesmo sistema.
E convém saber dos limites antes de desenhar em cima: entrada só de texto (imagem, áudio e vídeo ficaram de fora "por enquanto"), no máximo 255 opções por decisão — acima disso é preciso quebrar em duas etapas — e acesso por early access, com fila.
Quem está por trás
A TypeSafe é fundada por Diogo Almeida, pesquisador que passou pela OpenAI trabalhando nos métodos de instruction-following que sustentam o ChatGPT. Segundo ele, "a TypeSafe foi fundada para perseguir um caminho alternativo de pesquisa em IA, focado em IA nativa de máquina".
A empresa levantou US$ 40 milhões, em rodada liderada pela DCVC.
Conclusão
O Jev é interessante menos pelos múltiplos de marketing e mais pela observação que o sustenta: boa parte do que chamamos de "usar IA" dentro de software nunca precisou de conversa. Precisava de uma decisão, e a gente vinha pagando o preço de uma redação inteira para obtê-la.
Se a categoria pega, o efeito prático não é trocar seu LLM. É parar de usar um modelo de chat para responder uma pergunta de sim ou não — e, junto com isso, parar de tratar "veio no formato certo" como se fosse "veio certo". Essas duas coisas nunca foram a mesma, e nenhum schema vai fazer com que sejam.
Recomendações para este tema
Selecionados pela redação — só o que usaríamos.
Eficax Shop Informática e Games
Kit Gamer Periféricos Teclado Uma Mão
Bookcenter RJ
Kit Upgrade INTEL I5 4570 + Placa Intel H81 + Memória 8 GB+ Cooler
Eficax Shop Informática e Games
Kit Mobilador Completo de Headset Hub 3.0 Mouse Gamer Led Pad Speed Suporte de Celular
## faq
Perguntas frequentes
O que é o Jev da TypeSafe?
O Jev é o primeiro modelo da categoria que a TypeSafe chama de "System One": em vez de gerar texto token a token como um LLM, ele recebe um estado não estruturado e devolve um valor tipado — um booleano, uma opção de uma lista ou uma nota numa escala — acompanhado de probabilidade calibrada e score de confiança. Foi anunciado em 15 de setembro de 2026, em early access.
Qual a diferença entre o Jev e um LLM com saída estruturada (JSON mode)?
A garantia de formato é parecida: tanto o Jev quanto a decodificação restrita de um LLM impedem uma resposta fora do schema. A diferença que a TypeSafe defende é arquitetural e econômica — o Jev responde a consulta inteira em paralelo, numa única passada, em vez de gerar tokens em sequência, e por isso anuncia latência de 70 a 500 ms e saída gratuita. Também entrega probabilidade calibrada, coisa que um LLM em JSON mode não dá de forma confiável.
Quanto custa o Jev?
A TypeSafe anuncia US$ 0,042 por milhão de tokens de entrada (US$ 42 por bilhão) e tokens de saída gratuitos, descritos na documentação como "too cheap to meter". Para comparação, a própria empresa cita o GPT-5.6 Terra na faixa de US$ 2 a 12 por milhão de tokens.
É verdade que o Jev não alucina?
Depende do que se entende por alucinar. O modelo não consegue devolver uma resposta fora das opções declaradas, então erro de tipo ou de formato realmente não acontece. Mas isso não garante que a decisão esteja correta: uma resposta errada e bem tipada continua errada. A própria TypeSafe registra que o número de 0% "não é empírico" e vem da garantia de schema, não de medição.
O Jev substitui o ChatGPT ou o Claude?
Não, e nem tenta. O Jev não gera texto: não escreve código, não redige resposta para cliente, não resume documento. Ele foi feito para o outro tipo de chamada que existe dentro de software — classificar, rotear, pontuar, decidir — que hoje muita gente resolve pedindo JSON para um modelo de chat. Os dois convivem no mesmo sistema.
Quais são as limitações do Jev hoje?
A entrada é só texto: aceita strings, objetos JSON e arrays de texto, mas ainda não aceita imagem, áudio ou vídeo. Cada decisão suporta no máximo 255 opções, e casos com cardinalidade maior exigem dividir em duas etapas. Não há geração de string. E o acesso é por early access, com fila de espera.
Temas deste artigo
## continue lendo
Artigos relacionados
Continue navegando
Artigo anterior
Certificações em nuvem: AWS, Azure ou GCP
Comparativo das trilhas de certificação AWS, Azure e Google Cloud: custos reais, ordem de estudo, o que o mercado brasileiro pede e quando não compensa.
Leia maisSobre o autor